Innovación
Microsoft acelera su apuesta por chips propios de IA con Azure Maia 300
Microsoft llevará Azure Maia 300 a producción en 2027 y escalará su familia de chips para convertirla en base de inferencia de sus servicios de IA ya.
Lunes, Octubre 12, 2026
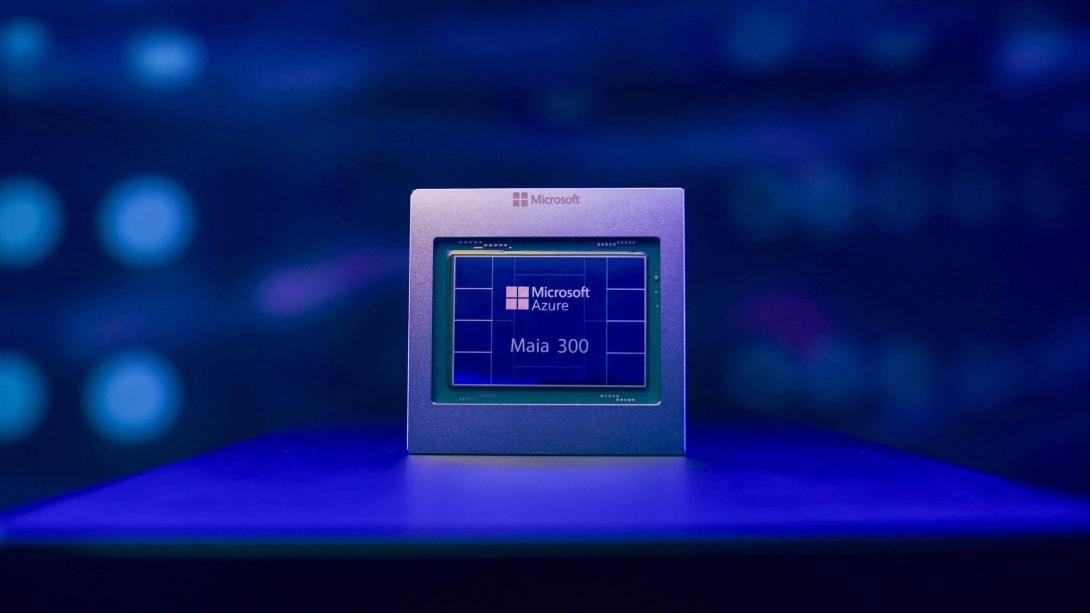
Microsoft llevará Azure Maia 300 a producción en 2027 y comenzará a escalar su familia de aceleradores propios a despliegues de varios gigavatios, una apuesta con la que busca convertir Maia en el sistema principal de inferencia para sus productos y servicios de inteligencia artificial.
El movimiento refuerza la estrategia de Microsoft de desarrollar silicio propio para reducir su dependencia de infraestructuras basadas exclusivamente en GPU y optimizar cargas como Copilot, Teams, GitHub Copilot y Microsoft Foundry.
El anuncio fue reforzado por Satya Nadella, presidente y CEO de Microsoft, quien calificó el movimiento como la mayor apuesta de la compañía hasta ahora por su propio silicio.
“Microsoft planea escalar Maia a despliegues de varios gigavatios desde 2027 y convertirla en el sistema principal de inferencia de sus propios productos y servicios, señaló Nadella en X.
Maia 200 ya está siendo utilizado en cargas de producción de Microsoft, mientras la compañía prepara la siguiente generación para atender modelos con mayor contexto, agentes de IA y aplicaciones sensibles a la latencia.
Azure Maia 300 promete 40% más tokens por megavatio
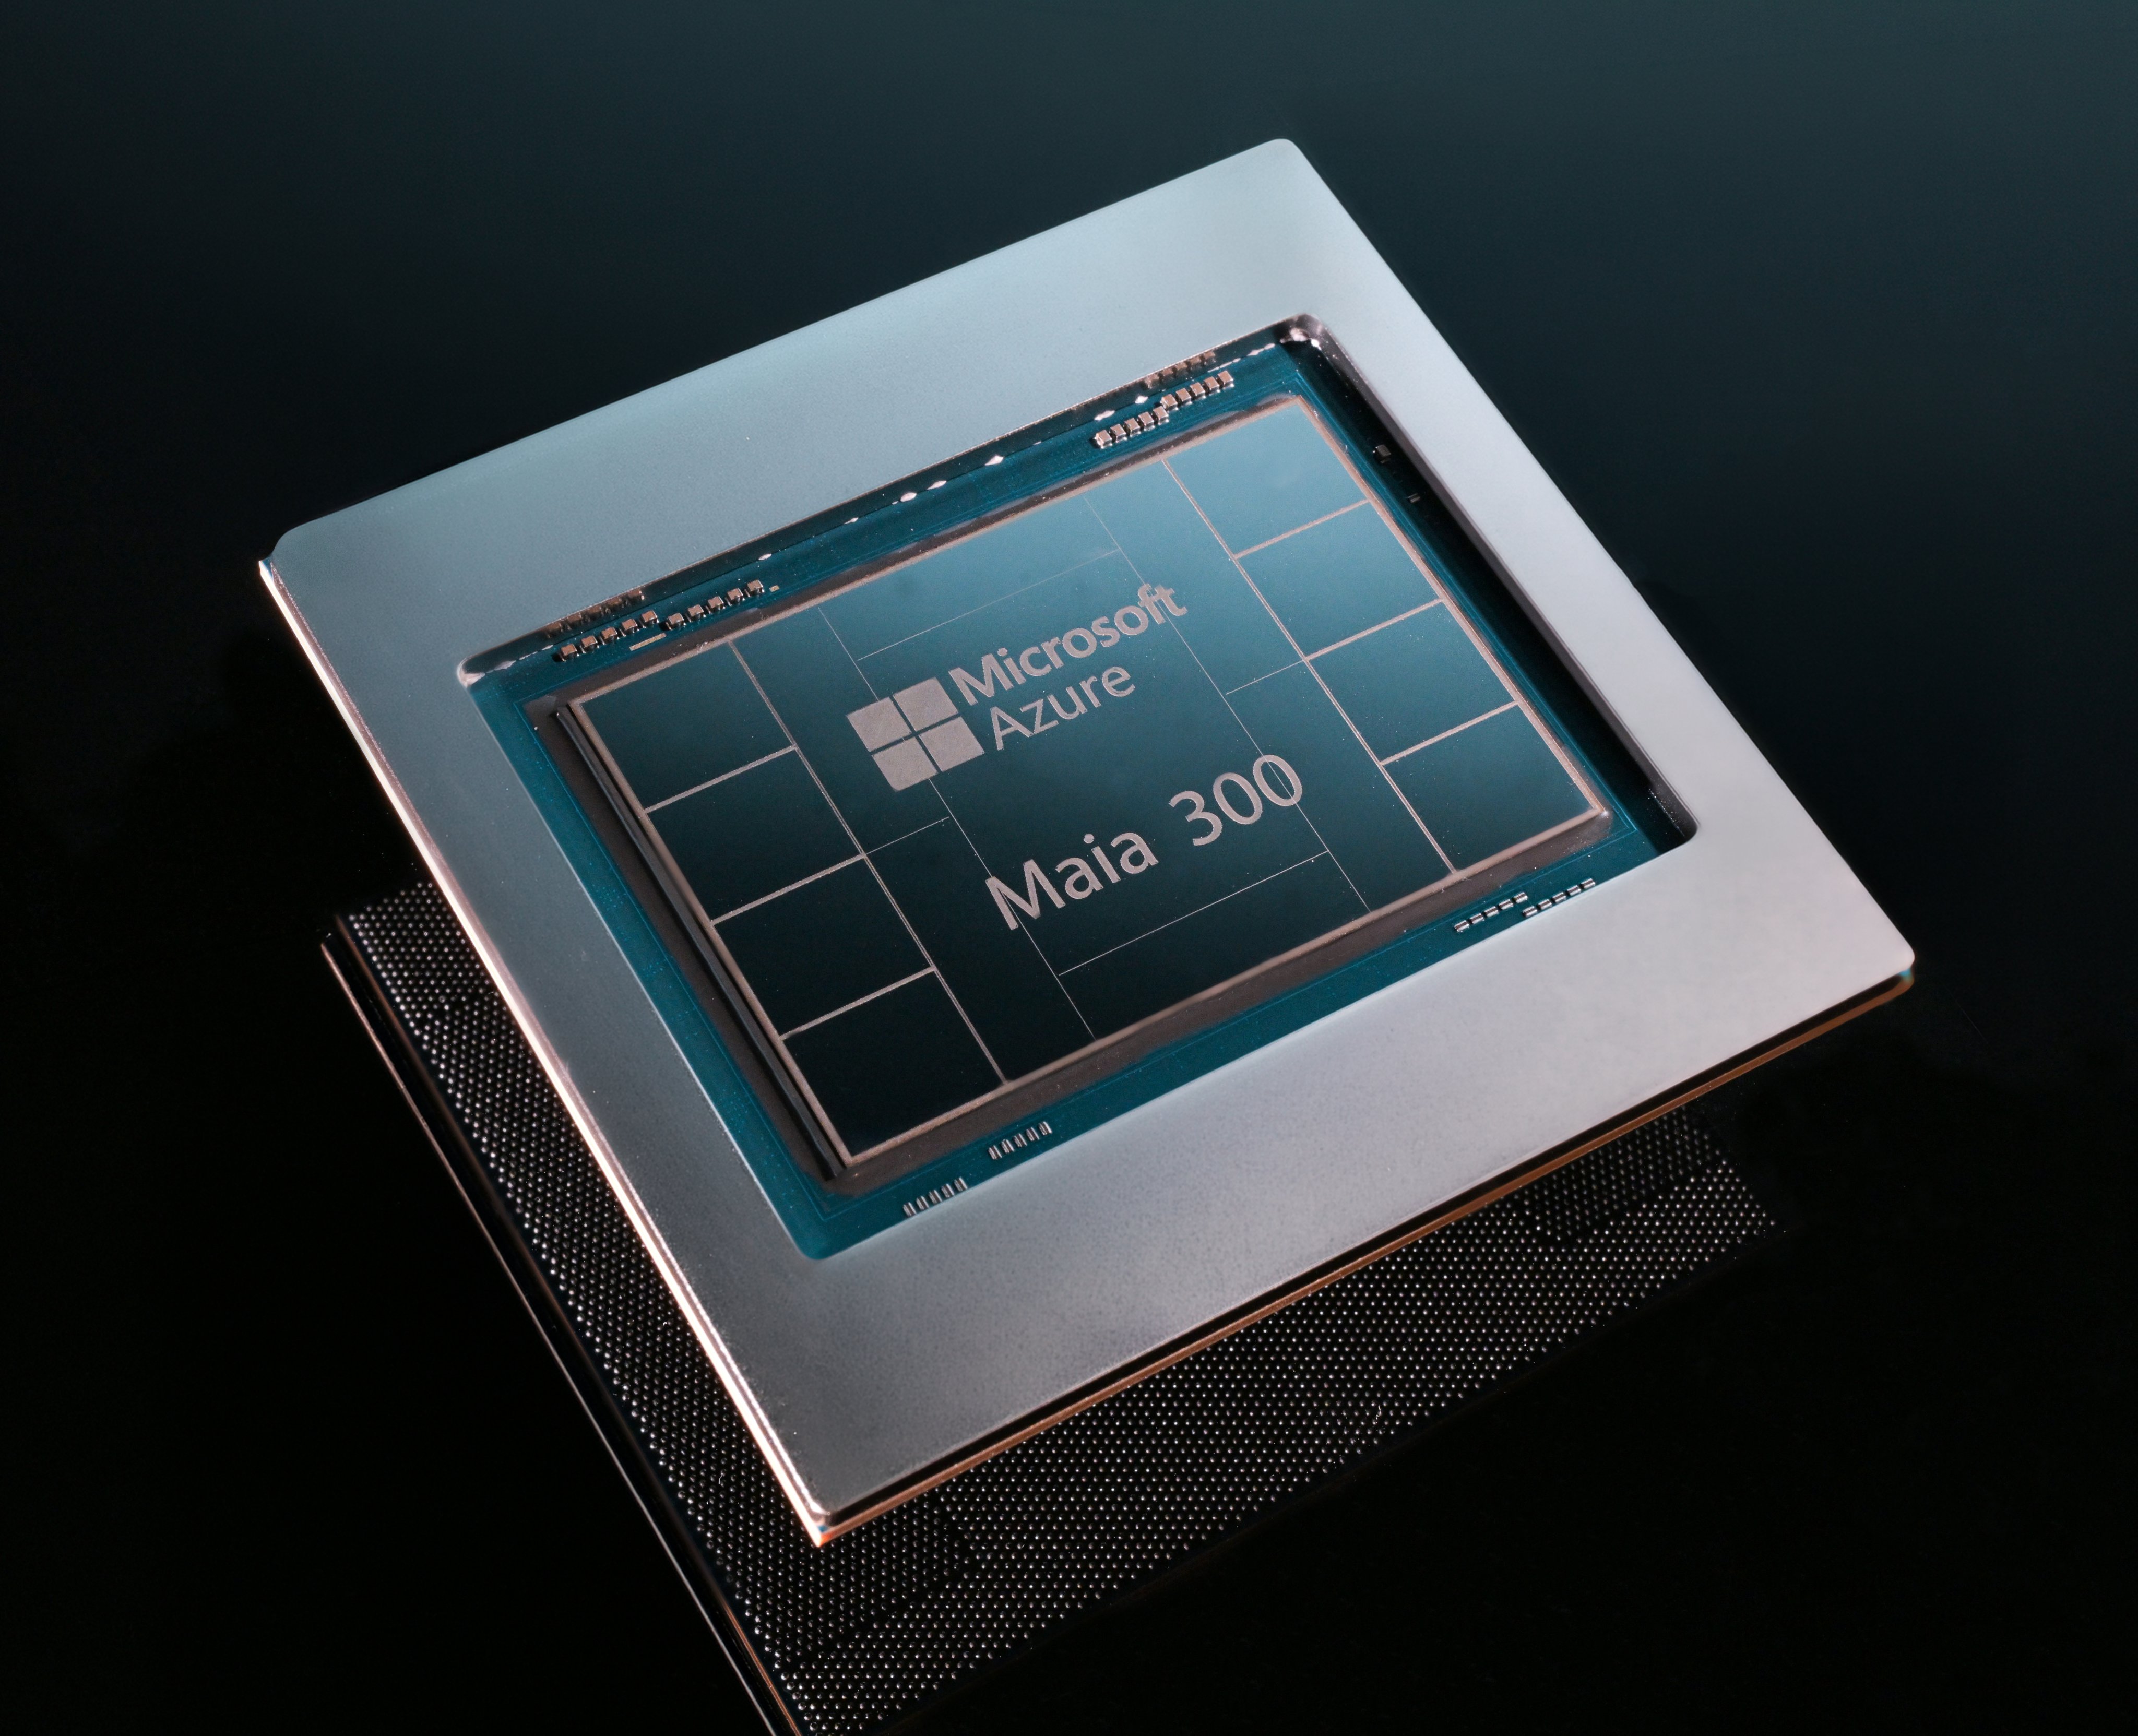
Según Microsoft, Maia 300 entregará 40% más tokens por megavatio frente a sistemas líderes basados en GPU.
La compañía también asegura que una configuración completa con 96 aceleradores podrá alcanzar hasta siete veces el rendimiento de tokens por rack de Maia 200.
Son resultados reportados por Microsoft y deberán contrastarse posteriormente con pruebas independientes cuando el sistema entre en producción.
El foco está en una variable que se está volviendo crítica para la industria: cuánta inteligencia artificial puede ejecutar un centro de datos con cada unidad de energía disponible.
Maia 200 ya procesa cargas de Copilot y Teams
La generación actual ya está siendo desplegada en Estados Unidos, Europa y Australia.
Microsoft afirma que Maia 200 puede entregar hasta 1,7 veces más tokens por watt en determinadas experiencias integradas en Teams, Copilot y Cowork frente a infraestructura GPU de referencia utilizada por la compañía.
El chip también ejecuta modelos de OpenAI, modelos propios de Microsoft y familias de código abierto.
La experiencia obtenida con esas cargas fue utilizada para diseñar Maia 300, bajo un modelo de desarrollo conjunto entre hardware y software.
Microsoft diseña Maia 300 para la era de los agentes de IA
Maia 300 tendrá una arquitectura orientada principalmente a inferencia y diseñada para cargas como razonamiento de contexto largo, conversaciones de baja latencia y tareas agentivas de múltiples pasos.
Entre sus especificaciones, Microsoft destaca ocho pilas de memoria HBM4 con 18 TB/s de ancho de banda máximo y un consumo térmico de diseño de 950 watts.
En configuración de rack, el sistema integrará 96 aceleradores, 27,6 TB de memoria HBM y un ancho de banda agregado de 1,7 PB/s dentro de un consumo aproximado de 167 kW.
La arquitectura también utiliza chiplets y procesos de fabricación TSMC N2P para mejorar el rendimiento por watt.
La energía se convierte en el nuevo cuello de botella de la IA
La importancia de Maia 300 no está únicamente en lanzar otro procesador. El crecimiento de la inteligencia artificial está obligando a Microsoft, Google, Amazon y otros grandes proveedores tecnológicos a optimizar simultáneamente chips, redes, memoria, refrigeración, energía y software.
A medida que los agentes de IA ejecuten tareas más largas y complejas, la eficiencia energética se convertirá en una variable económica determinante.
Microsoft quiere controlar una mayor parte de esa cadena.
La compañía plantea que, desde 2027, Maia pase a ser la infraestructura principal de inferencia de sus propios servicios, aunque mantendrá un ecosistema heterogéneo con tecnologías de diferentes proveedores.
La implicación para el mercado es relevante: la próxima batalla de la inteligencia artificial no se librará únicamente entre modelos. También se jugará en quién pueda producir más capacidad de IA con cada watt, cada rack y cada dólar invertido en infraestructura.
Tal vez te has perdido
Infografía del día
Lo más leído
- Negocios
- Innovación
- Actualidad
- Actualidad
- Innovación